Samenvatting
Eén Likertitem is ordinaal: de antwoorden hebben een volgorde, maar de afstand tussen ‘eens’ en ‘helemaal eens’ ligt niet vast. Een Likertschaal, de som of het gemiddelde van meerdere items die samen één begrip meten, wordt in de praktijk meestal als interval behandeld.
In het kort
Je rapporteert een gemiddelde van 3,74 op een vijfpuntsschaal en je promotor zet in de marge ‘ordinaal?’. Deze pagina zet de analysekeuzes naast elkaar, legt uit waarover de discussie precies gaat en zegt wat een lezer in je methode moet kunnen terugvinden.
Upload je pdf voor een gratis previewBinnen enkele minuten een eerste opmerking bij een deel van je eigen tekst. Volledige evaluatie vanaf 3,99 euro.
Voorbeeld · meetniveau tegenover analyse
Fictief fragment uit de resultaten van een bachelorproef verpleegkunde (vragenlijst bij patiënten van twee afdelingen)
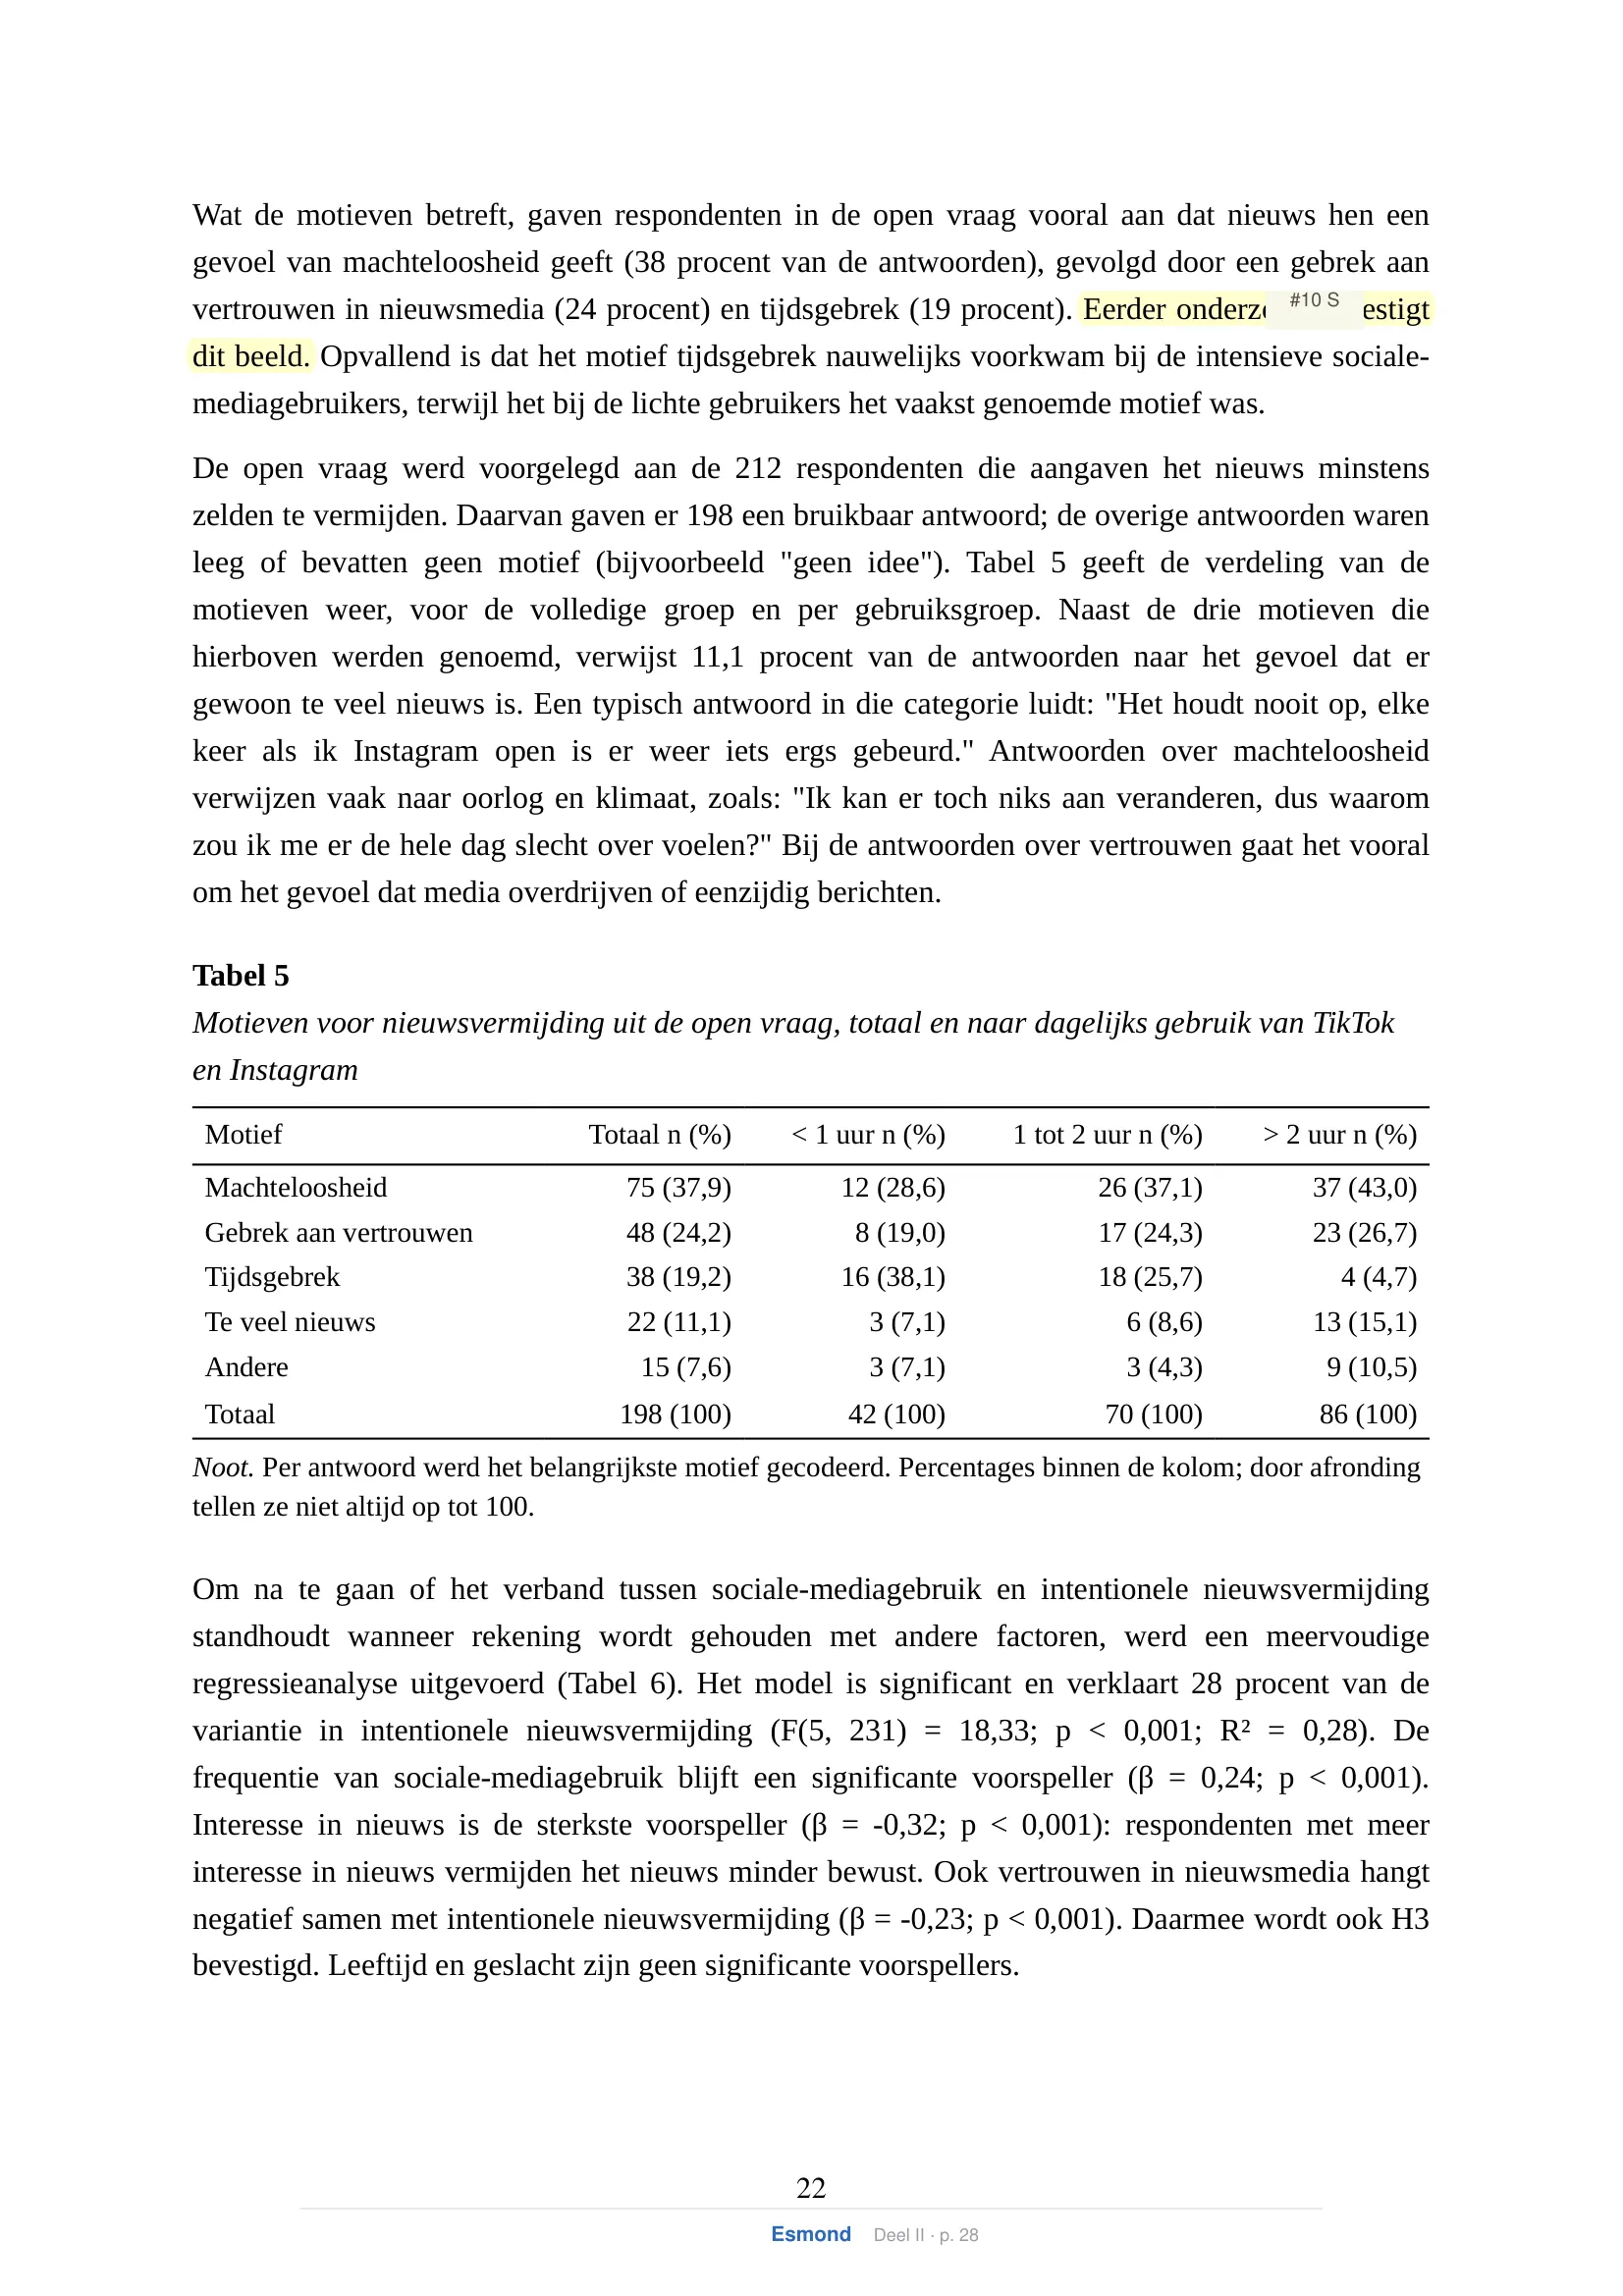
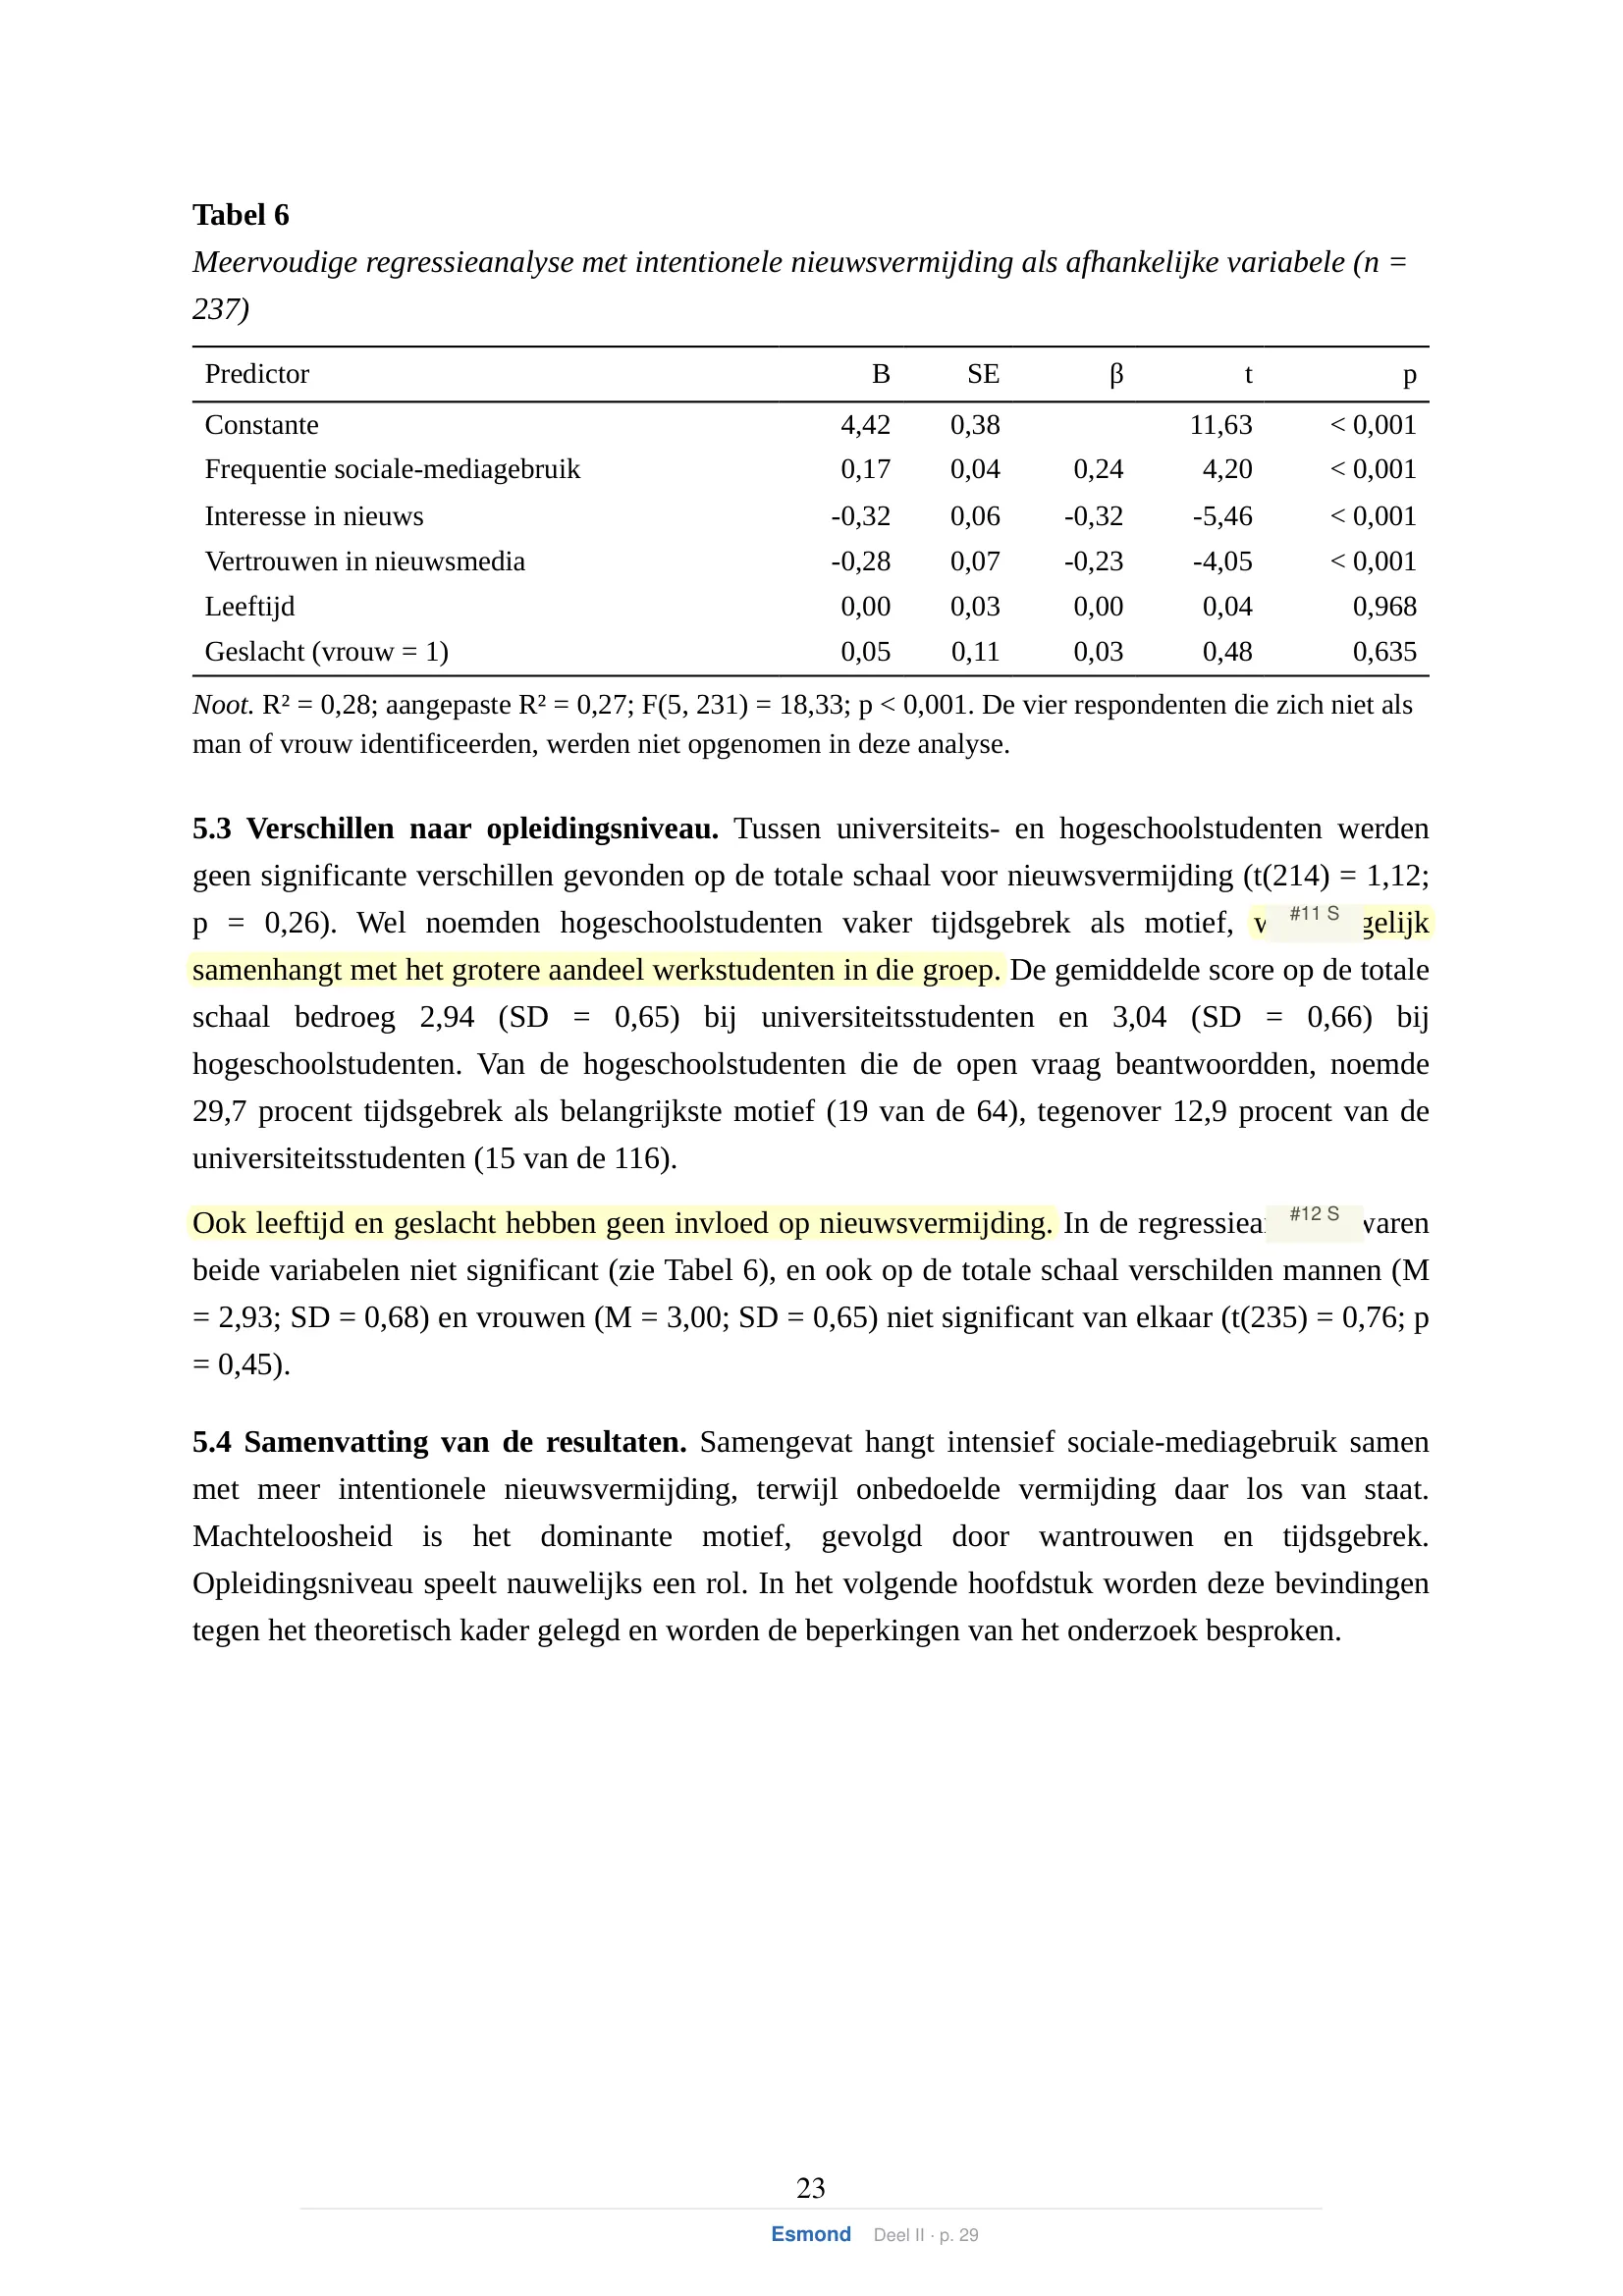
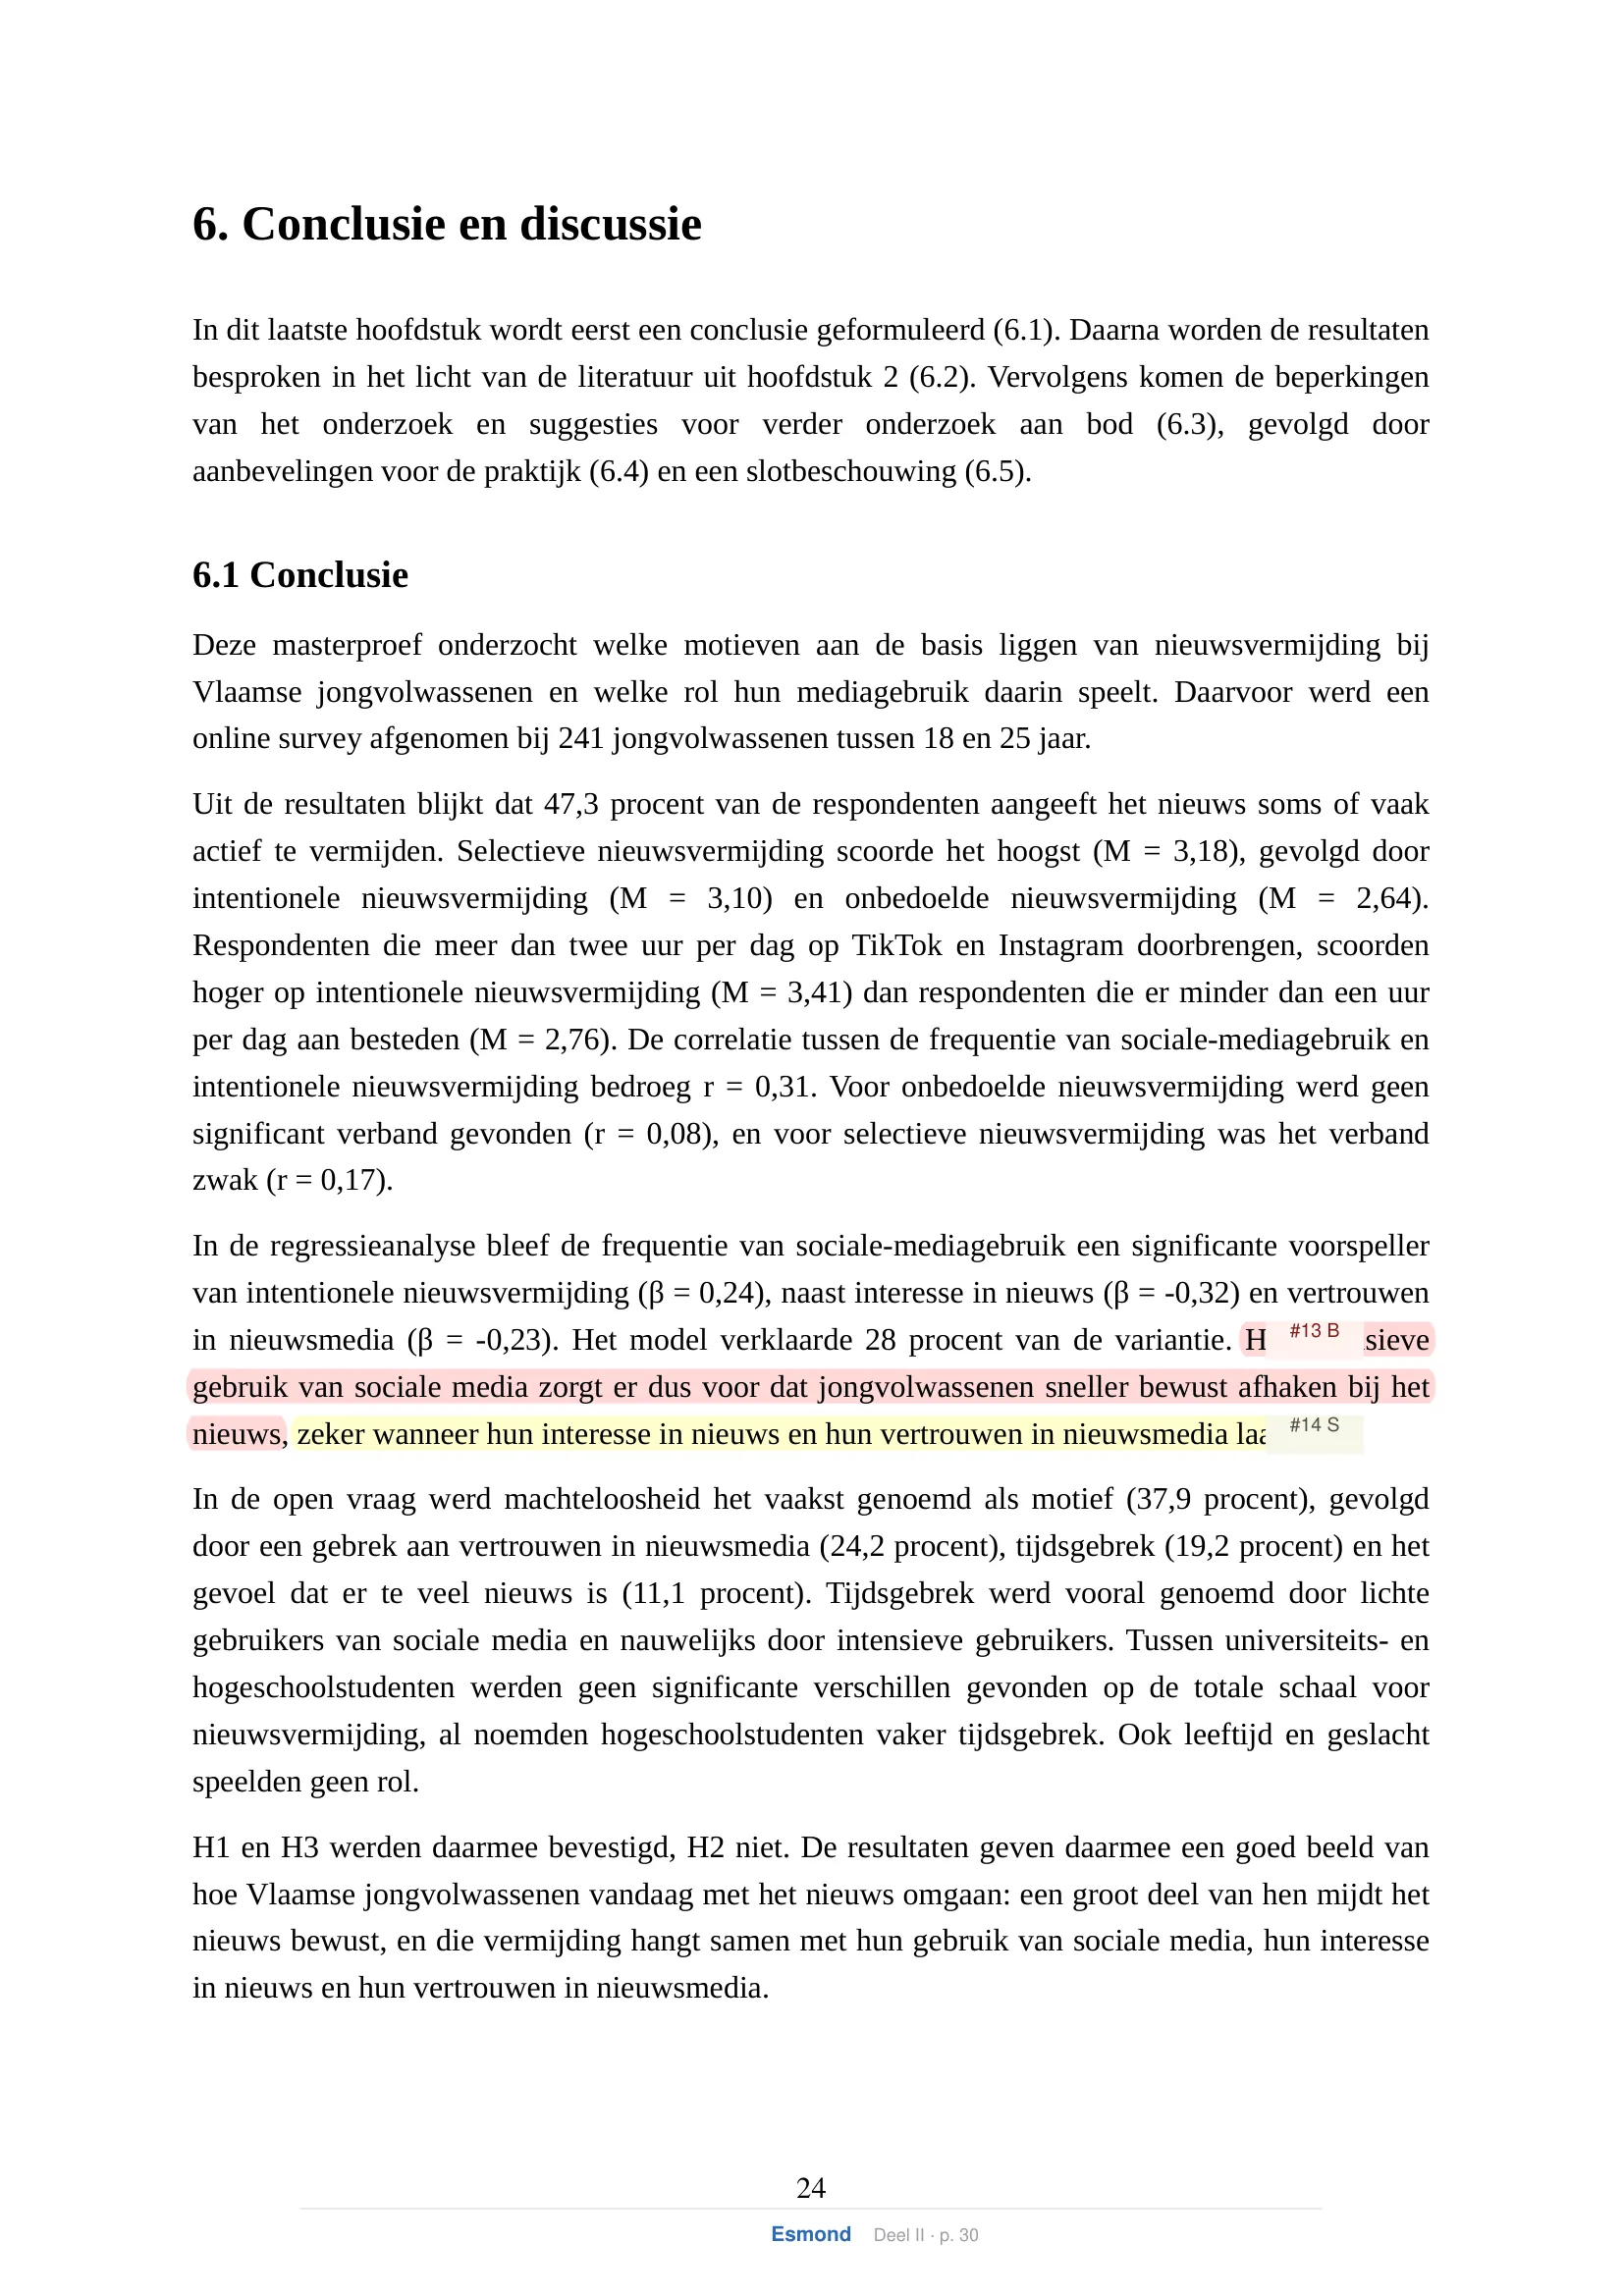
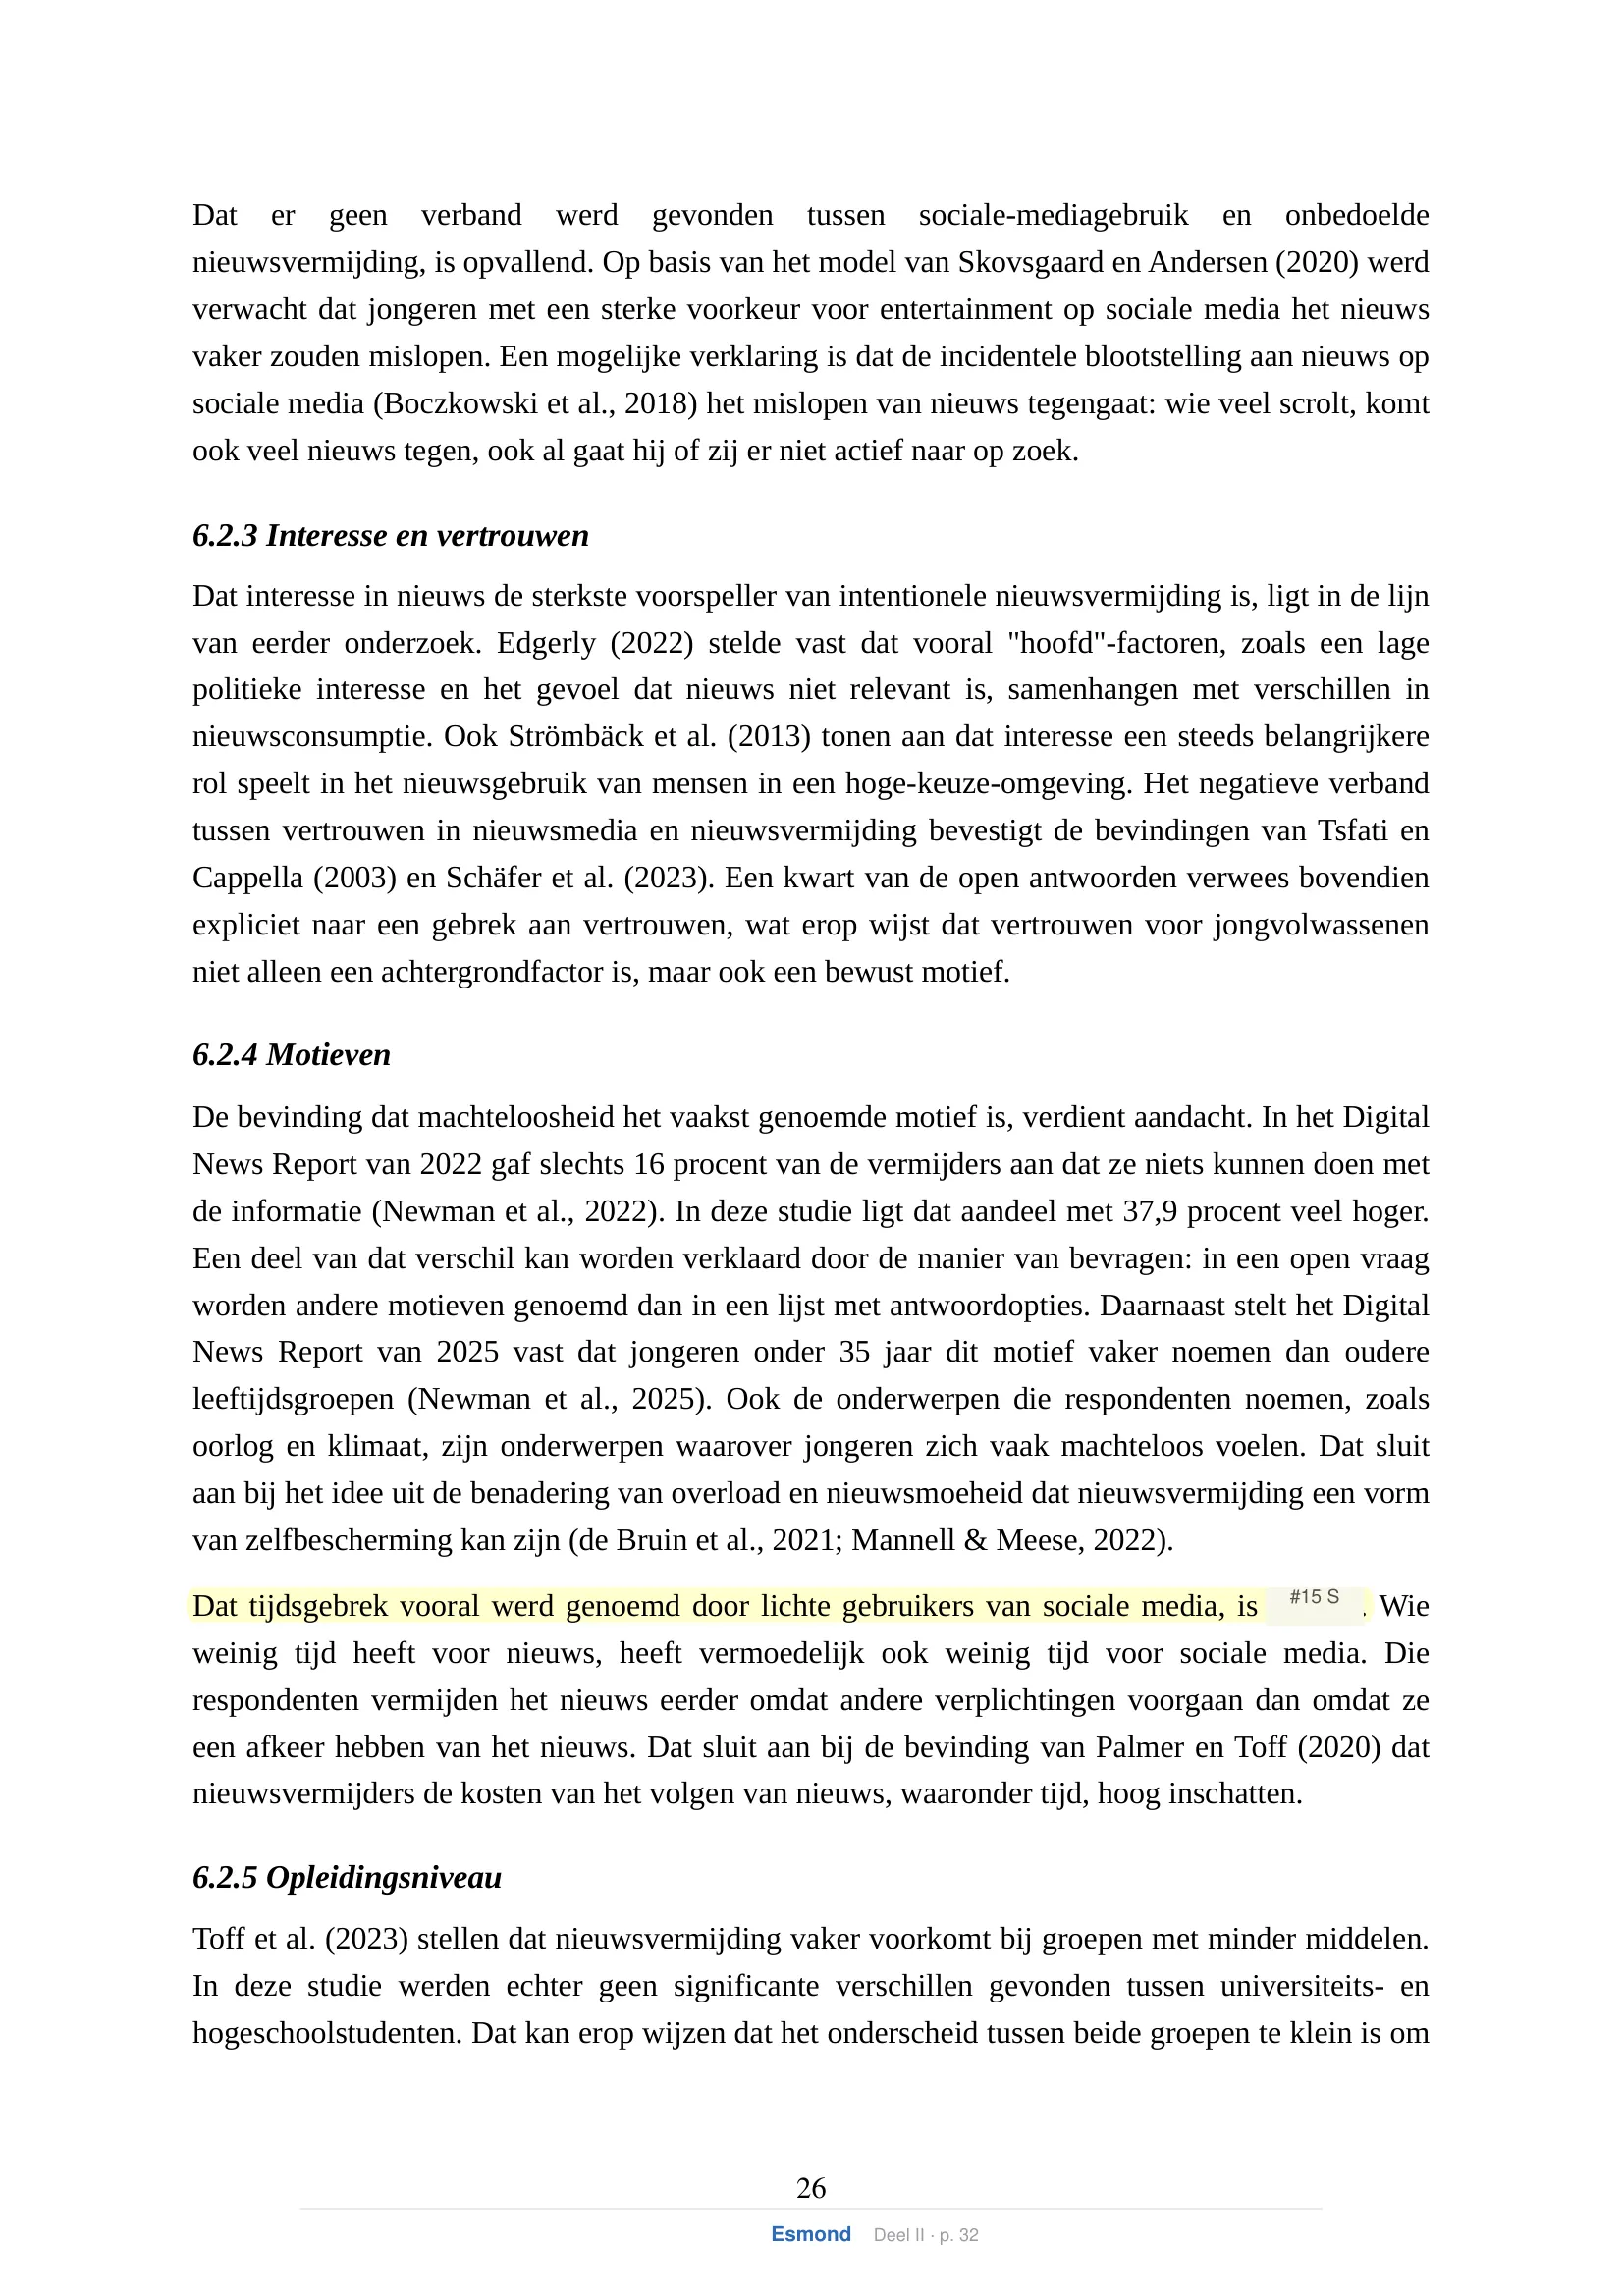
Op het item ‘Ik wist bij mijn ontslag welke medicatie ik moest nemen’ scoorde afdeling A gemiddeld 3,74 en afdeling B 3,52 (t = 2,11; p = 0,04). Ook op de elf andere items werd een t-toets uitgevoerd; drie daarvan waren significant. De nieuwe ontslagbrochure van afdeling A verhoogt dus de tevredenheid.
Het item meet of patiënten wisten welke medicatie ze moesten nemen; je besluit spreekt over tevredenheid. Een t-toets op één item behandelt het bovendien als interval. Controleer of je methode zegt welk meetniveau je aanneemt en waarom.
Twaalf afzonderlijke toetsen zonder correctie voor het aantal toetsen verhogen de kans op een toevallig significant resultaat. Heb je overwogen of de items samen een schaal vormen?
‘Verhoogt’ is een causale uitspraak. Twee afdelingen op één moment vergelijken toont een verschil. Of de brochure dat verschil veroorzaakt, kan je hiermee niet zeggen.
Fictief fragment. Elke opmerking wijst een plek in de tekst aan.
De vraag ‘ordinaal of interval’ heeft twee lagen. De eerste gaat over wat je analyseert: één item of een schaal van meerdere items. De tweede gaat over wat je wil zeggen: een verdeling beschrijven, groepen vergelijken of een verband modelleren. Volgens Carifio en Perla (2007) komt veel verwarring van het eerste punt: wie over ‘Likertschalen’ spreekt, bedoelt vaak losse items.
| Aanpak | Verdedigbaar als | Wat je ermee kan zeggen | Waar je op let |
|---|---|---|---|
| Eén item als ordinaal: frequenties, mediaan, toetsen zoals Mann-Whitney U of Spearman (een gewone chi-kwadraattoets kan ook, maar negeert de volgorde) | Je wil tonen hoe antwoorden op één uitspraak verdeeld zijn, of je items vormen geen schaal. | Hoe antwoorden verdeeld zijn en of groepen anders antwoorden. | Veel losse toetsen per item vergroten de kans op toevallige resultaten. |
| Eén item als interval: gemiddelde, t-toets | Je argumenteert het met een bron over de robuustheid van parametrische toetsen, en de verdeling is niet extreem. | Een verschil in gemiddelden, met de kanttekening dat de afstanden tussen de categorieën verondersteld zijn. | Een gemiddelde kan een verdeling met twee pieken verbergen. Toon ook de frequenties. |
| Schaalscore van meerdere items als interval: gemiddelde, t-toets, variantieanalyse, Pearson, regressie | De items meten samen één begrip: de schaal komt uit een bestaand instrument of werd zo ontworpen, en je controleert in je eigen steekproef de samenhang (bijvoorbeeld met alfa of omega) en waar het kan of de items één dimensie vormen (factoranalyse). | Verschillen en verbanden op het niveau van het begrip dat de schaal meet. | Betrouwbaarheid van de schaal in je eigen steekproef, omgekeerd geformuleerde items hercoderen. Bij groepen van ongelijke grootte en spreiding een toets die geen gelijke varianties veronderstelt (Welch). |
| Ordinaal model: bijvoorbeeld ordinale logistische regressie | Je wil één item of een korte schaal als uitkomst modelleren zonder de intervalaanname. | Hoe de kans op een hogere antwoordcategorie samenhangt met andere variabelen. | Het gangbare model veronderstelt proportionele odds; controleer die aanname. Vraagt meer statistische kennis, dus overleg met je promotor of dit in je opleiding gangbaar is. |
Of je methode past bij je vraag en je resultaten volstaan voor wat je beweert, leest Esmond bij je thesis laten nalezen.
De auteurs verschillen van mening over de analyse. Sullivan en Artino vragen in elk geval dat een lezer kan nagaan welke aanname je maakt, en dat je in de methode bespreekt "why they have chosen to portray and analyze their data in a particular way". Kies je de interval-lezing voor schaalscores, steun dan op Carifio en Perla of Norman. Voor losse items steunt alleen Norman die lezing, en Liddell en Kruschke waarschuwen daar net voor. Kies je de ordinale lezing, steun dan op Jamieson. Wissel niet tussen beide binnen hetzelfde hoofdstuk zonder dat te verantwoorden.
Een lezer zoekt in je methode naar het volgende:
Fictief voorbeeld. Een bachelorproef verpleegkunde vraagt: ‘Verschilt de tevredenheid over ontslaginformatie tussen patiënten van twee chirurgische afdelingen?’ De vragenlijst heeft zes items op een vijfpuntsschaal, overgenomen uit een bestaand instrument, ingevuld door 64 patiënten.
De student telt de zes items op tot één schaalscore, rapporteert de betrouwbaarheid in de eigen steekproef en vergelijkt de afdelingen met een Welch-t-toets, met een verwijzing naar Carifio en Perla (2007) voor de interval-lezing van een schaalscore. Per item staan de frequenties in een bijlage.
Wat de studie laat besluiten: of de tevredenheid over ontslaginformatie verschilt tussen patiënten van deze twee afdelingen in deze periode, en hoe groot dat verschil is. Wat niet: dat de werkwijze van één afdeling dat verschil veroorzaakt, want patiënten en ingrepen verschillen ook. Ook niet: dat het verschil geldt voor andere ziekenhuizen, of dat er geen verschil is als de toets niet significant is.
Fictief voorbeeld. Een bachelorproef secundair onderwijs vraagt: ‘Hoe zeker voelen startende leerkrachten zich over klasmanagement, en verschilt dat tussen leerkrachten in hun eerste en derde jaar?’ De student ontwierp zes items, één per situatie (zoals het begin van de les, overgangen en storend gedrag), telkens op een vijfpuntsschaal. Omdat de items niet als schaal ontwikkeld of getest werden, behandelt de student ze afzonderlijk.
De student behandelt elk item als ordinaal: frequenties per antwoordcategorie in een gestapelde staafgrafiek, de mediaan, en voor het verschil tussen leerkrachten in hun eerste en derde jaar een Mann-Whitney U-toets op drie items die al in het onderzoeksvoorstel als kern gekozen waren. Die keuze vooraf staat in de methode.
Wat de studie laat besluiten: in welke situaties deze leerkrachten zich zeker of onzeker voelen, en of dat verschilt tussen beide groepen in deze steekproef. Wat niet: of ze in de klas ook zo handelen, want zelfrapportage meet een inschatting. Ook niet: dat ervaring de zekerheid doet groeien. Leerkrachten die afhaken, zitten niet in de groep van het derde jaar, en een groei vraagt metingen bij dezelfde leerkrachten op twee momenten.
Esmond leest of je onderzoeksvraag, je meetinstrument, je analyse en je besluit op elkaar aansluiten. Het wijst passages aan waar je niet zegt welk meetniveau je aanneemt, waar je beschrijving van een toets niet past bij hoe je je data beschreef, en waar je besluit verder gaat dan een vragenlijst op één moment toelaat. Esmond rekent je statistiek niet na, controleert geen output uit SPSS, R of JASP, schrijft niets voor je en geeft geen cijfer. Eerst zie je een gratis preview, daarna beslis je of je de volledige evaluatie wil.
Letterlijke citaten uit de open-accessversies van Carifio en Perla (2007) bij Science Publications en van Sullivan en Artino (2013) bij PubMed Central, geraadpleegd op 9 november 2026. Van Norman (2010) werd de samenvatting geraadpleegd. Jamieson (2004) staat hier zoals Carifio en Perla en Sullivan en Artino haar weergeven; Likert (1932), Stevens (1946) en Liddell en Kruschke (2018) staan hier als parafrase.
Een bachelorproef toegepaste psychologie vraagt of de ervaren werkdruk bij medewerkers van een kinderopvangorganisatie samenhangt met de steun die ze van hun leidinggevende ervaren. Beide begrippen worden gemeten met schalen uit een bestaande Engelstalige vragenlijst, die de student vertaalde. Een van de schalen bevat twee omgekeerd geformuleerde items.
De student hercodeert eerst die items, berekent per schaal het gemiddelde over de items en rapporteert de betrouwbaarheid in de eigen steekproef. De methode verantwoordt de vertaling: wie vertaalde, of er een terugvertaling was en of enkele mensen uit de doelgroep de items vooraf lazen. Het verband tussen beide schalen wordt beschreven met een correlatie, met een bron voor de interval-lezing.
Een promotor kan vragen: hangen de omgekeerde items na hercodering positief samen met de rest van hun schaal? Meten de vertaalde items nog hetzelfde begrip als het origineel, en hoe ga je dat na?
Een masterproef handelswetenschappen vraagt welke kenmerken van een aankoop in een webwinkel samenhangen met de intentie om er opnieuw te kopen. Die intentie is één item met vijf antwoordcategorieën, van ‘zeker niet’ tot ‘zeker wel’.
Omdat de uitkomst één ordinaal item is, kiest de student een ordinale logistische regressie, met levertijd, retourbeleid en leeftijd als verklarende variabelen. De methode zegt hoe de aanname van proportionele odds gecontroleerd werd. De resultaten staan als odds ratio's: hoe de odds op een hogere antwoordcategorie veranderen met elke verklarende variabele.
Een jurylid kan nagaan: lees je een odds ratio in je besluit als een kans? Heb je bekeken hoeveel antwoorden in elke categorie vielen, en als je categorieën samenvoegde, staat de reden in je methode?
Een masterproef communicatiewetenschappen bevraagt jongvolwassenen over hun vertrouwen in nieuws op sociale media, met acht uitspraken op een vijfpuntsschaal. Bij elke uitspraak konden ze ook ‘weet ik niet’ aanduiden.
De student behandelt ‘weet ik niet’ als ontbrekend antwoord en rapporteert per item hoe vaak die optie gekozen werd. Wie die optie als middencategorie codeert, leest een ontbrekend oordeel als een neutraal oordeel. Per item staat de verdeling in een staafgrafiek, omdat bij twee items een gemiddelde rond het midden twee tegengestelde groepen verbergt.
Een promotor kan vragen: verschillen de mensen die vaak ‘weet ik niet’ kozen van de anderen, bijvoorbeeld in leeftijd of nieuwsgebruik? Hoe ga je om met die ontbrekende antwoorden als je de items samenneemt tot één schaal?
In je opleiding of faculteit:
Eén Likertitem is ordinaal. Een schaal die meerdere items optelt, wordt in de praktijk meestal als interval behandeld, en verschillende methodologen verdedigen dat. Zeg in je methode welke lezing je volgt en steun ze op een bron.
Voor een schaalscore van meerdere items is dat gangbaar. Voor één item is het omstreden: het veronderstelt dat de afstanden tussen de antwoordcategorieën gelijk zijn. Doe je het toch, verantwoord het en toon ook de verdeling van de antwoorden.
Nominaal: categorieën zonder volgorde (studierichting). Ordinaal: categorieën met een volgorde, zonder vaste afstand (helemaal oneens tot helemaal eens). Interval: gelijke afstanden zonder echt nulpunt (temperatuur in graden Celsius). Ratio: gelijke afstanden met een echt nulpunt (leeftijd, aantal).
Beide komen veel voor. Neem je een bestaand instrument over, houd dan het aantal punten van dat instrument aan, anders kan je je resultaten niet vergelijken met eerder onderzoek. Ontwerp je zelf items, verantwoord dan je keuze en test de vragenlijst eerst bij een paar mensen uit je doelgroep.
Laatst herzien op
Laat je tekst evalueren voor je indient